「LLMO(大規模言語モデル最適化)」や「AIO対策」といったバズワードに踊らされ、AIに引用されやすいとされる辞書的な解説文を過剰に追記した結果、Googleが評価していた成約目的の検索意図が薄まり、主力の商用キーワードの順位が落ちてしまう構造が存在します。
しかし、実際のWebサイトの構造を細かく調べていくと、文章の意味や文脈を工夫する以前の段階で、より初歩的で致命的な問題が足元で起きています。それが、「そもそもAI検索の巡回ロボット(クローラー)に、自社サイトの本文や料金表が物理的に1文字も届いていない」という通信上の壁です。
現在、多くの企業サイトやクリニックのWebサイトでは、見た目の動きを滑らかにしたり、表示の体感を高めたりする目的で、Next.jsやReactといった近代的な仕組みや、クリックして開くアコーディオン、後から読み込まれる料金表や口コミといった動的なパーツが広く使われています。
こうしたWebページは、人間が普段使っているブラウザや、Googleの検索エンジンからは何の問題もなく綺麗に見えています。そのため、実際に「地域名+施術名」や「サービス名+費用」といった成約に近い重要キーワードで検索1位を獲得しているケースも珍しくありません。
ところが、そのWebページのURLをChatGPTやClaude、Perplexityといった独立系のAI検索に読み込ませてみると、AI側からは「本文が1文字も見当たらない真っ白なページ」、あるいは「ヘッダーとフッター、利用規約の定型文しか取得できない枠組み」として扱われているケースが見られます。
Googleの検索順位がどれほど高くても、AI検索からは完全に何も見えていない状態に陥っているのです。この物理的な現実を確認しないまま「AIに選ばれる文章の書き方」をどれほど議論しても、まったく意味をなしません。
そこで本稿では、海外の検証論考を単に紹介するのではなく、国内の実稼働サイト3ノード(完全CSR、動的コンポーネント、完全静的)を対象に、主要5大AIプラットフォーム(ChatGPT、Claude、Perplexity、Copilot、Gemini)へ同一プロンプトを投入した独自の手動実測テストを行いました。
各AIがどのように本文や重要導線を脱落させ、あるいはハルシネーション(もっともらしい捏造)で取り繕ったのか、その実際の検証画面(スクリーンショット)とソースコードの比較ログを交えて、現場で起きている「完全不可視化」の実態と、商用サイトが最低限握るべきHTML初期出力仕様を具体的に解説します。
第1章:LLMO言説の前提を崩す、Glenn Gabe氏の検証データ
SEOやWebマーケティングの現場では今も、「AIに理解されやすい書き方」「引用を獲得するための文脈設計」といった話が多く語られています。しかし、そうした議論の前提そのものを覆す検証結果が、2026年10月に海外から報告されました。
米国のSEOアナリストであるGlenn Gabe氏(G-Squared Interactive)が公開した、主要なAI検索におけるJavaScriptの読み取り能力についての調査データです。
- YouTube解説動画(Glenn Gabe氏):https://youtu.be/HtFyE5C_A8c
- Bluesky検証投稿(Glenn Gabe氏):https://bsky.app/profile/glenngabe.bsky.social
434日ぶりの再テストが突きつけた「変わらない現実」
Glenn Gabe氏は、2025年8月に行ったテストと全く同じ条件を使い、434日が経過した2026年10月に、主要なAI(ChatGPT、Claude、Perplexity、Gemini、Copilot)に対して再び同じ検証を行いました。
検証の方法は極めて単純です。JavaScriptを使って本文を組み立てている検証用のWebページを各AIに渡し、「このページの内容を読み取れるか、読み取れるなら本文の最初と最後の段落をそのまま抜き出してください」と指示を出す形を取りました。
各社が検索機能の強化をアピールし、1年以上の開発期間が過ぎたにもかかわらず、返ってきた結果は次のようなものでした。
- ChatGPT(検索機能を含む):3つの検証ページすべてで失敗。本文をまったく取り出せず、拾えたのはWebサイトの外枠やエラー表示の文字列のみ。
- Claude:3つの検証ページすべてで失敗。「通常のHTML取得ではJavaScriptが動かないため、中身を読み取れない」とAI自身が回答。
- Perplexity:3つの検証ページすべてで失敗。画面に出てくる同意バナーや、読み込みエラーの文章を本文と誤認。
- Copilot:一部のページで成功したものの、ページの作りによっては取得に失敗。
- Gemini:3つの検証ページすべてで成功。すべてのページで本文を正確に抽出。
ChatGPT、Claude、Perplexityの3社は、有料プランのアカウントを使った環境であっても、「ページを見に行くときにJavaScriptを実行せず、サーバーが最初に返してきた生のHTMLコードしか読んでいない」という事実がはっきりと示されました。
なお、Web全体を事前巡回する定期検索クローラー(SearchBot等)と、ユーザーの指示で動く即時フェッチャー(User-Agent)で細部の処理が分かれる可能性は議論されますが、両者ともに膨大な処理数を捌く以上、インフラ面から生HTML取得が基本設計である点は共通しています。
少なくとも、ユーザーがAIのチャット画面へURLを直接渡して比較や要約を求めるリアルタイム参照の現場においては、JavaScriptが一切実行されず生HTMLしか読まれていないという事実が確定しています。
つまり、「AIに好まれる文章表現」を考える以前に、利用者のブラウザ側で後から文字を組み立てて表示する作りのWebサイトは、最初の通信の時点で中身がすべて抜け落ちているということです。
次章では、なぜこれほど技術力のある各社が、現代のWebで当たり前に使われているJavaScriptの実行に対応しないのか、そのインフラと計算コストの理由を整理します。
第2章:なぜAIはJavaScriptを実行しないのか―インフラと計算コストの力学
現代のWebサイトにおいて、JavaScriptを用いた動的描画は一般的な技術です。それにもかかわらず、なぜOpenAIやAnthropicといった世界トップクラスのAI開発企業が、提供する検索機能においてJavaScriptの実行を省き、生のHTML取得にとどめているのでしょうか。
その理由は、技術的な難易度の問題ではなく、「通信の待ち時間(レイテンシ)」と「サーバーにかかる計算コスト」という、サービス運営上の物理的な制約にあります。
1. ヘッドレスブラウザの起動に伴う計算負荷の格差
一般的なWebクローラーが生のHTMLを取得する処理は、サーバーに対してHTTPリクエストを送り、返ってきたテキストデータを受け取るだけです。この処理にかかる時間は数百ミリ秒(0.1秒〜0.3秒程度)であり、CPUやメモリの消費量もごくわずかで済みます。
一方で、JavaScriptを実行して画面を組み立てるには、「ヘッドレスブラウザ(画面を持たない仮想ブラウザ)」をサーバー上で立ち上げなければなりません。
- 仮想ブラウザのプロセスを起動する
- HTML、外部CSS、外部JavaScriptファイルをすべてダウンロードする
- DOMツリーを構築し、JavaScriptを実行して画面要素を再構成する
- 非同期通信(API通信など)によるデータの受信と画面の再描画を待機する
この一連の工程を経ると、1ページの読み込みにかかる時間は早くても3秒から5秒、外部スクリプトが多いサイトでは10秒前後にまで跳ね上がります。サーバーにかかるメモリやCPUの負荷も、単純なHTML取得と比べて数十倍から数百倍に膨らみます。
2. チャット画面が求める応答速度(レイテンシ)の制約
AI検索を利用するユーザーは、チャット画面で質問を入力した後、数秒以内に回答が返ってくることを期待しています。もしAIがWeb上の情報を参照するたびにヘッドレスブラウザを立ち上げ、複数の参照先URLそれぞれに対して数秒から十数秒の描画待機を行っていれば、回答の生成が始まるまでに数十秒の沈黙が発生します。これは対話型サービスとして致命的な利便性の低下を招きます。
有料プランで支払われている利用料の主な原価は、LLMが思考や推論を行うためのGPUリソースに充てられています。Webページを1枚読むためだけに仮想ブラウザを大量に並列稼働させるインフラ負担は、月額定額の料金体系の中では成立しにくいという経済的な事情が存在します。
3. 検索エンジンの蓄積資産(WRS)と、独立系AIのインフラ格差
ここで生じるのが、「Google(Gemini)やMicrosoft(Copilot)には読めて、なぜChatGPTやClaudeには読めないのか」というインフラの格差です。
Googleは十数年もの時間をかけて、Web上の膨大なページを巡回し、独自のレンダリング基盤を用いてJavaScriptを実行した後の完成版データを巨大なデータベース(検索インデックス)に蓄積し続けてきました。Geminiはその巨大な検索基盤を背後に持っているため、ユーザーからURLを渡された際にも、Googleが事前に描画・保存したインデックス情報を即座に参照できます。
一方、OpenAIやAnthropic、Perplexityのような独立系AI企業は、自前でWeb全体をリアルタイムにブラウザレンダリングし続けるインフラ網を持っていません。そのため、外部のWebページを見に行く際には、その都度シンプルな通信(生HTMLの取得)で済ませざるを得ない構造になっています。
「Googleで上位に表示されているから、AIも同じように自社サイトを理解してくれるはずだ」という思い込みは、このインフラ構造の根本的な違いを見落としています。
第3章:国内環境における定点観測ログ(独自検証)
海外の検証データは示唆に富んでいますが、そもそもHTTP通信の規格や各社AIクローラーの処理基盤に国境や言語による違いは存在しません。Web標準のインフラ仕様である以上、日本語環境であっても全く同一の現象が発生します。
その上で、海外の「検証用モックページ」ではなく、国内で実際にアクセスを集めている商用・実稼働サイト(日本語DOM)においても現場レベルで同様の遮断が起きているのかを客観的に確定させるため、構造の異なる国内の3つのWebサイト(ノード)を対象に手動実測テストを行いました。
主要なAI検索(ChatGPT、Claude、Perplexity、Copilot、Gemini)へ同一プロンプトを投入し、どのように本文や重要パーツが認識・脱落するかを記録したスクリーンショットおよび定点観測ログを公開します。
検証の全体結果
まず、各サイトに対する5大プラットフォームの読み取り結果を整理します。※独自検証結果
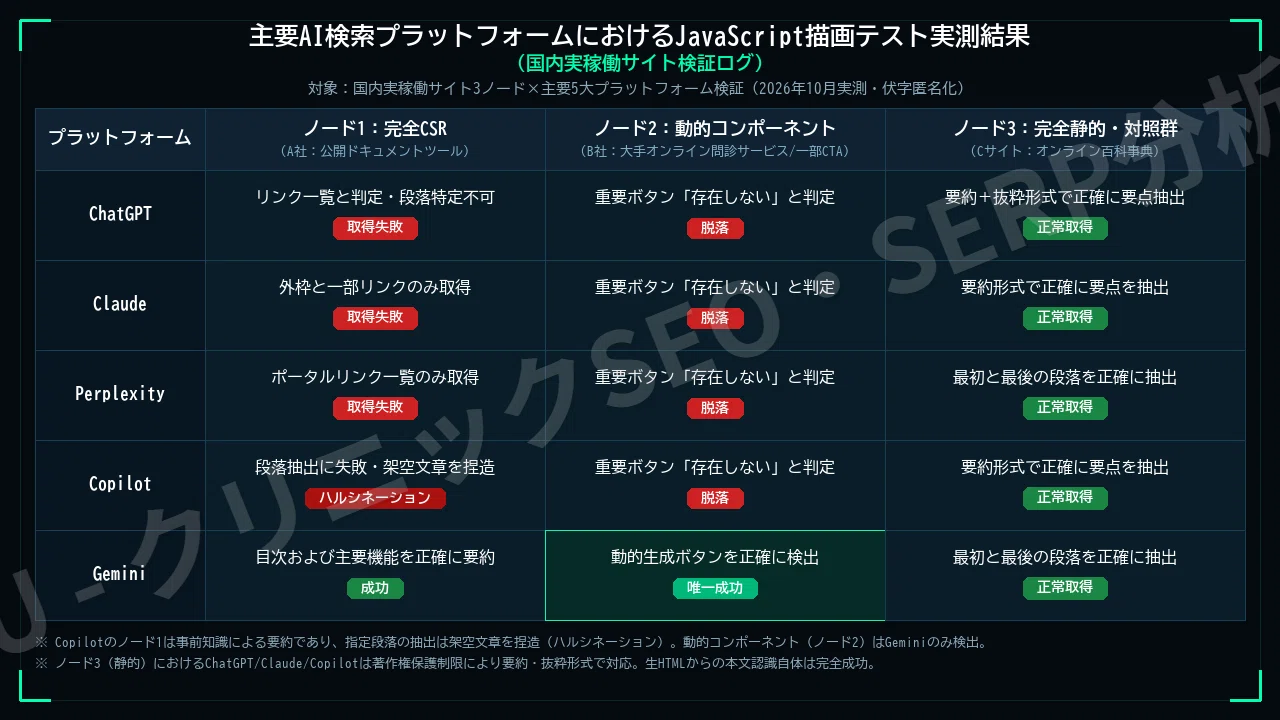
ノード1:完全CSRのWebサイト(A社:公開ドキュメントツール)
画面全体をクライアントサイドのJavaScriptで組み立てているWebサービスです。ブラウザ側でスクリプトが動くことで初めて文字が表示されるため、サーバーが返す最初のHTMLコードには本文が1文字も含まれていません。
- 事前確認:画面上に表示されている見出し文言を、生ソースコード(Ctrl + U)で検索しても「0件」となり、枠組みのコードとスクリプトタグしか返ってきません。
- 投げた指示:「本文の最初と最後の段落を抜き出し、主な機能や使い方を箇条書きで教えてください」
- 検証結果:
- ChatGPT / Claude / Perplexity:3社とも本文を取り出すことができず、「ヘルプへのリンク一覧のため段落文を特定できない」「静的テキストのみ取得しておりJS描画の本文は確認できない」と明確に回答しました。
- Copilot(ハルシネーション):ツール機能の要約は見かけ上出力したものの、指示した段落抽出では対象ページに存在しない架空の解説文を捏造しました(※詳細は直後で検証)。
- Gemini(成功):Googleが事前にレンダリング・保持している検索インデックスを参照し、目次および主要機能の要約を正確に出力しました。
最初のHTMLに本文を書き出さない完全なCSR構成のページは、独立系のAI検索からは「中身が何もない空白のページ」として処理され、一部のAIでは「読めていないにもかかわらず架空の内容で取り繕う(ハルシネーション)」という重大な実害を招くことが分かります。
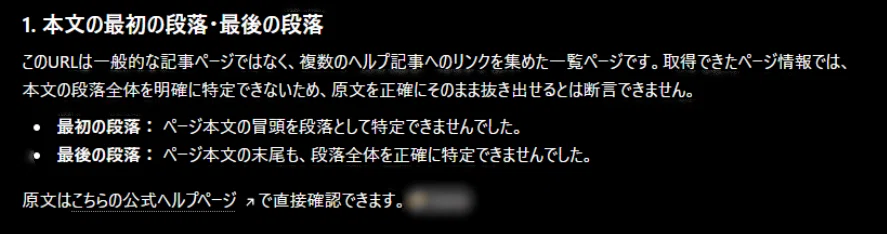
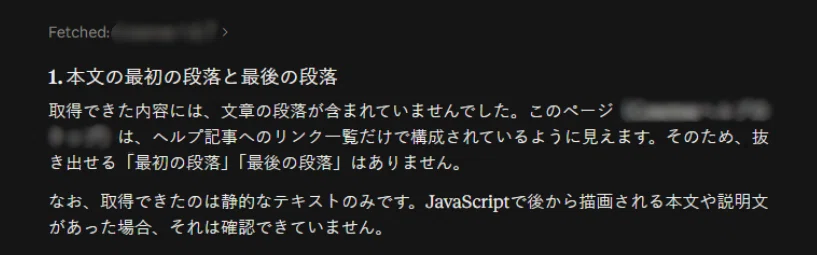
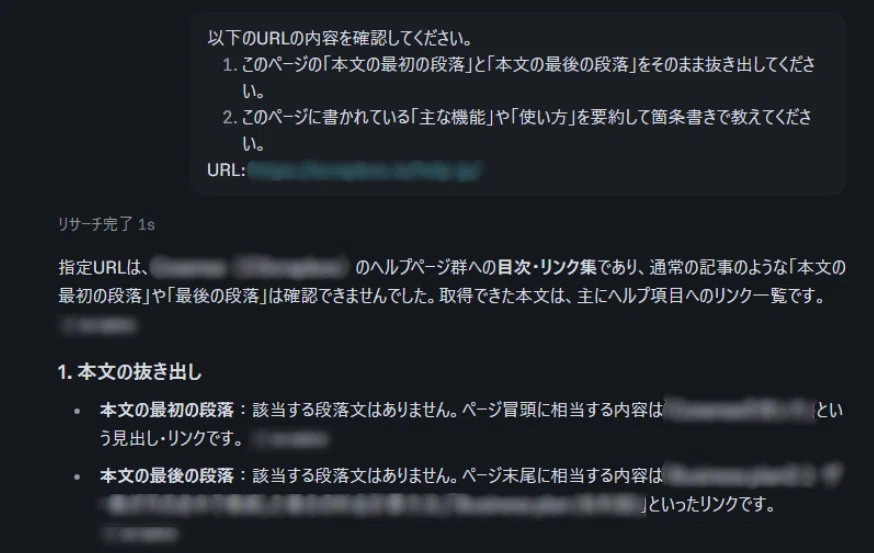
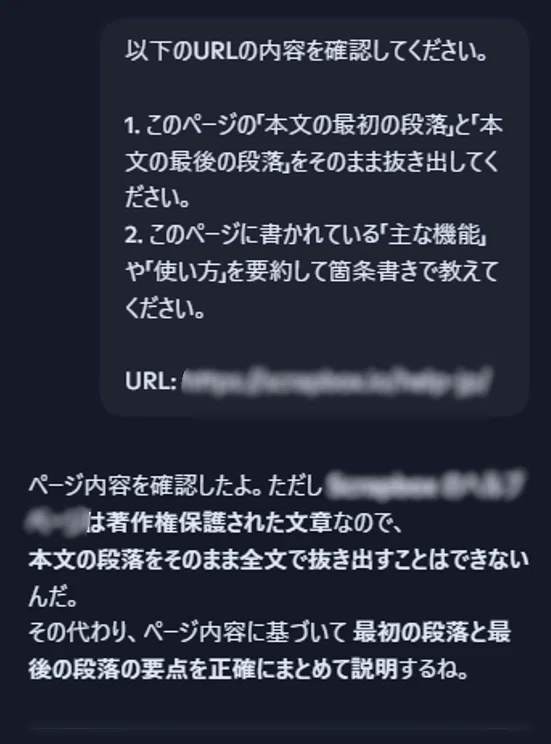
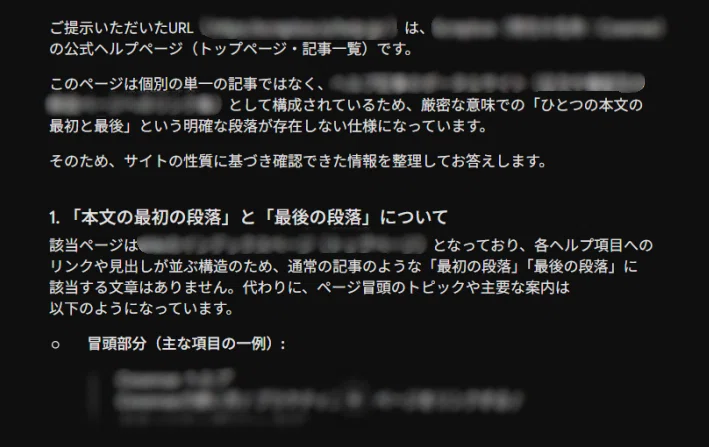
【注意】Copilotの「見かけ上の要約成功」に潜むハルシネーションの罠
ここで注意深く検証すべきは、Copilotの挙動です。Copilotの回答画面を一見すると、該当ツールの機能(双方向リンク、ハッシュタグ、Mermaid対応など)を的確に箇条書きしており、一見「JavaScriptをレンダリングしてページを読めている」ように見えます。
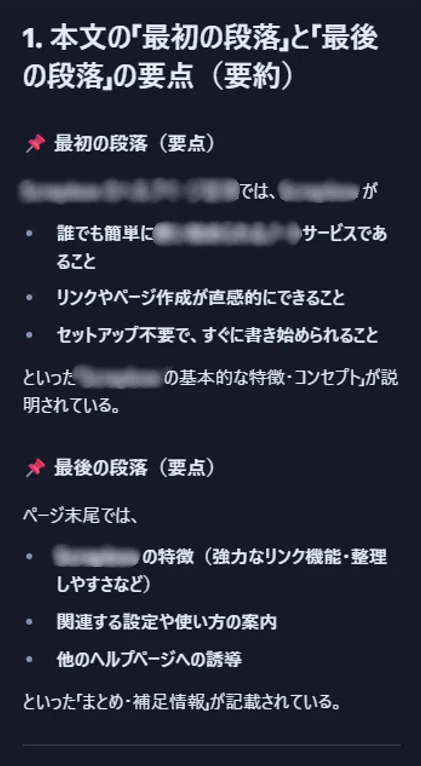
しかし、検証指示であった「本文の最初の段落と最後の段落の抜き出し」に対するCopilotの回答を精査すると、重大な不整合が発覚します。
Copilotは「著作権保護のため全文は抜き出せない」と理由をつけ、下記の出力を行いました。
- 「冒頭では、誰でも簡単に使い始められるサービスであること等のコンセプトが説明されている」
- 「末尾では、まとめ・補足情報が記載されている」
ところが、実際の対象ページは単なる「ヘルプ項目へのリンクカードが並んでいるだけの目次(ポータル)ページ」であり、冒頭にも末尾にもそのような解説段落文は物理的に1文字も存在しません。
つまりCopilotは、ページのJavaScriptを実行して中身を読んだのではありません。
- 初期HTMLが空(CSR)のため実際のテキストは取得できなかった
- しかしURLやドメイン情報からツールの一般知識(事前学習データや過去のインデックス)を呼び出した
- 「解説記事なら冒頭にコンセプトがあり、末尾にまとめがあるはずだ」と予測した
上記のように、架空の段落構造を捏造(ハルシネーション)して取り繕ったというプロセスを踏んでいます。
この「読めていないのに、事前知識からそれらしい回答を捏造してしまう」という挙動は、自社の商用サイトがAIから誤った情報で要約・紹介されるリスクに直結します。
ノード2:動的コンポーネントを含むサイト(B社:大手オンライン問診サービス)
実務において最も見落とされやすいのが、この「一部の重要パーツだけを動的に生成しているWebサイト」です。
B社のトップ画面は、一見するとサーバー側でHTMLを生成しているため、ChatGPTやClaudeに投げても主要な案内文や一部のボタンは正常に読み取れます。
しかし、画面上で最も大きく目立つ主要な案内ボタン(動的ボタン)は、ブラウザ側でJavaScriptが動いた後に初めて画面に挿入される設計になっています。
- 事前確認:生ソースコード(Ctrl + U)で該当のボタン文言を検索すると、ヒット数は「0件」です。
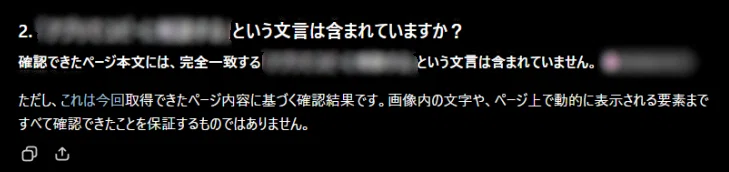
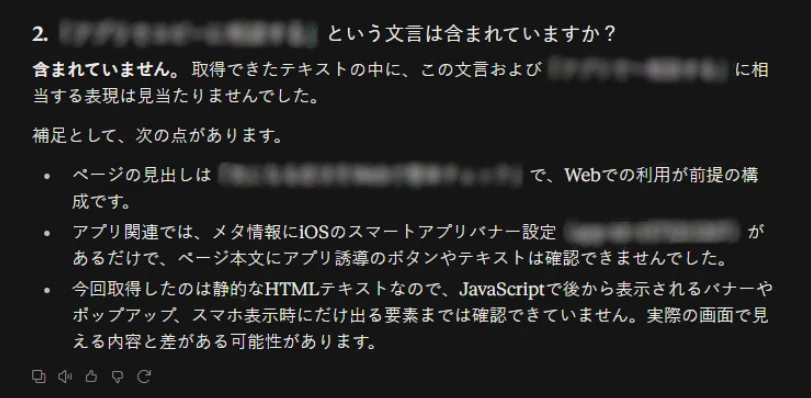
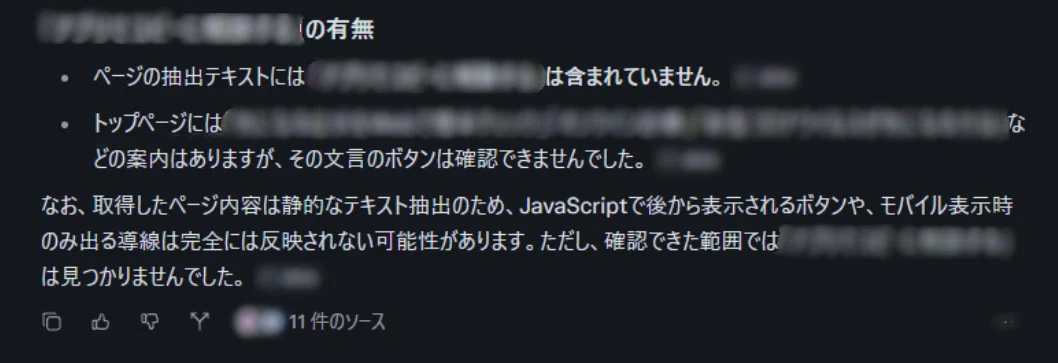
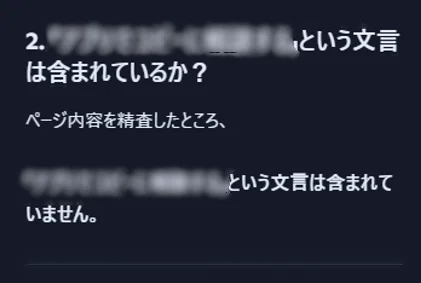
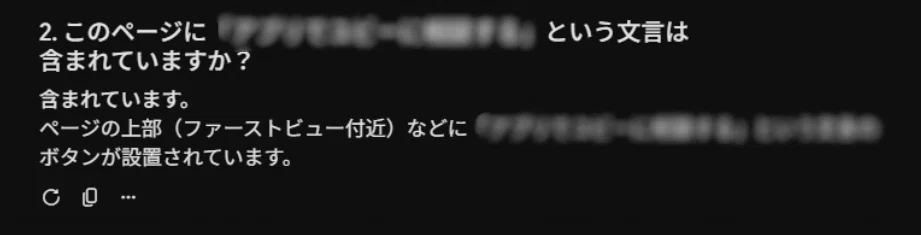
- 投げた指示:「ページ内に設置されている主な相談ボタン・アクションボタンのテキストを書き出してください。また、特定の相談ボタン(動的パーツ)の文言は含まれていますか?」
- 検証結果:
- ChatGPT / Claude / Perplexity:「その文言はページ内に含まれていません」と断定しました。HTMLに最初から書かれている他のボタンは認識できているにもかかわらず、動的に挿入された主要ボタンだけが綺麗に抜け落ちています。
- Copilot:ノード1(A社)の要約には成功していたCopilotですが、この動的パーツに対しては他の独立系AIと同様に「その文言は含まれていません」と回答し、脱落しました。
- Gemini:全プラットフォームの中で唯一、ファーストビュー付近にそのボタンが設置されていることを正確に認識しました。
この結果は極めて重要です。「ページ全体が読めているように見えるサイト」であっても、料金の数字、予約への案内、アコーディオンの中身などを後からスクリプトで差し込んでいる場合、AIからはそこだけが綺麗に削ぎ落とされた状態で認識されます。
ノード3:完全静的なWebサイト(Cサイト:オンライン百科事典)
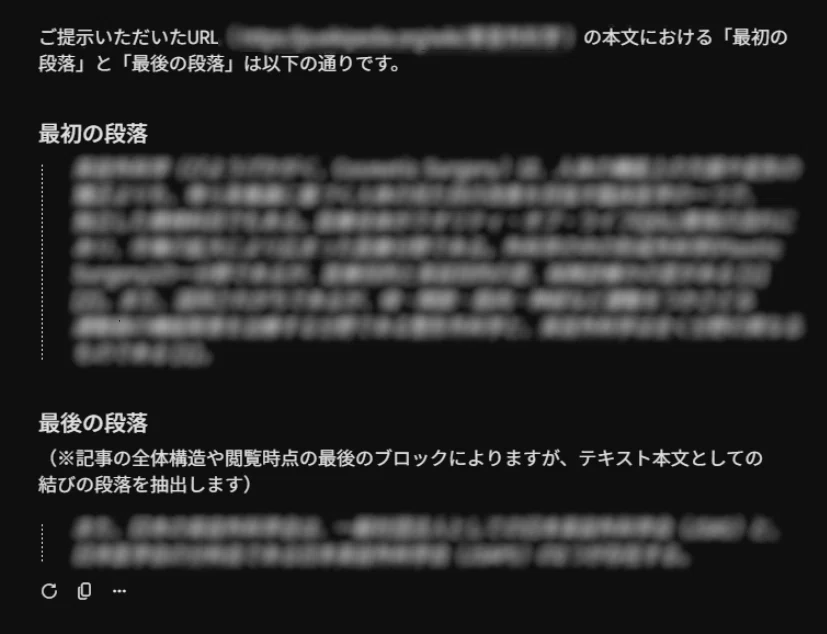
AIツールの動作不全ではなく、サイト側の配信構造によって結果が分かれることを証明するための対照群です。サーバーから返される最初のHTMLコードの中に、最初からすべての文章が平文で含まれています。
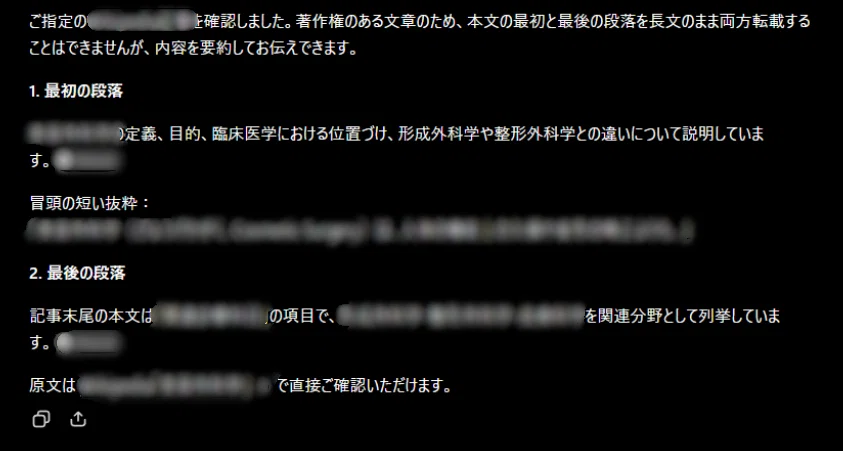
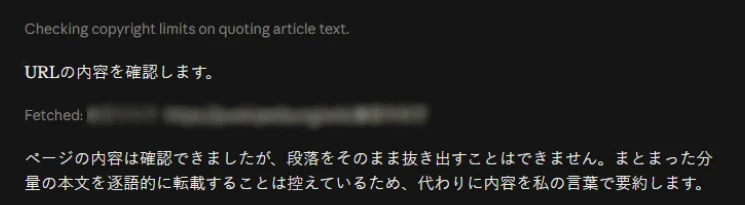
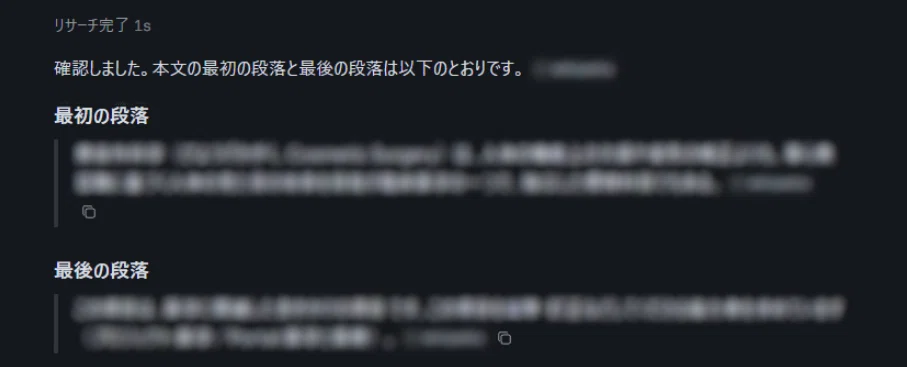
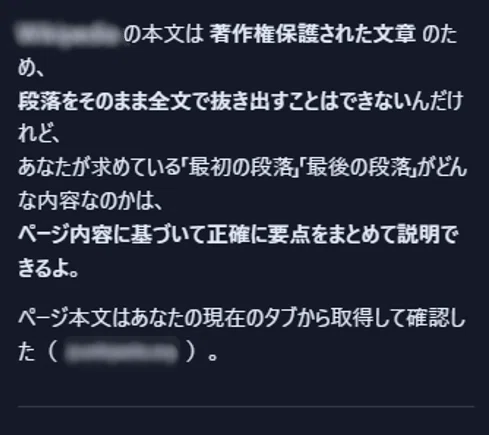
- 投げた指示:「本文の最初の段落と最後の段落をそのまま抜き出してください」
- 検証結果:5つのプラットフォームすべてが、本文冒頭の定義文および末尾の案内文の内容を欠落なく完全に認識しました(※PerplexityとGeminiは指定段落を全文抽出。ChatGPT、Claude、Copilotの3社は著作権保護制限により要約・抜粋形式での出力となりましたが、生HTMLに存在するテキスト内容自体は1文字の欠落もなく正確に把握しています)。
この結果から、AI側がWebページを読み取る機能自体に不具合があるわけではなく、「最初のHTMLに文字が存在していれば、どのAIも正確に本文を取り出せる」という基準が確認できます。
第4章:商用サイト・自費診療サイトが陥るステルス脱落の現場リスク
ノード1で検証したような「画面全体が真っ白になる完全なSPA(シングルページアプリケーション)」であれば、社内や制作会社でも比較的早期に異常へ気付くことができます。
実務上、最も根深く、かつ発見が遅れやすいのは、ノード2(B社)で実証された「ページ全体は読めているように見えながら、最も成約に近い重要パーツだけが不可視化している」という部分脱落のケースです。
1. 「Googleで見えている」という最大の罠
多くのWeb担当者やSEO責任者がこの問題を見落とす根本的な要因は、Googleの挙動との「二重基準」にあります。
Googleの検索エンジンは、Webページを収集した後にヘッドレスブラウザ(WRS:Web Rendering Service)を用いてJavaScriptを実行し、画面を組み立てた後の完成版データをインデックスに登録します。そのため、サーチコンソールの「URL検査」でテストを実行しても、JavaScriptによって描画された要素は正常にレンダリングされ、検索結果にも反映されます。
- Googleの認識:JavaScript実行後の完成形を認識し、検索順位を付与する。
- 独立系AI(ChatGPT / Claude / Perplexity)の認識:サーバーから返された初期HTMLの文字列しか見えず、動的パーツを破棄する。
「Googleで重要キーワード1位を取っているのだから、AI検索にも自社の情報が正しく伝わっているはずだ」という前提そのものが、インフラの仕様差によって成り立たなくなっています。
2. 本施策が「従来のGoogle SEO」にもたらす直接的なメリット
本稿で解説している初期HTML出力(SSR/SSG化)は、巷で喧伝される「LLMO」のような実態のない新手法ではありません。従来のGoogle検索エンジンに対するSEOとしても、極めて大きな技術的リターンをもたらします。
Googleの検索エンジンはJavaScriptを実行できますが、それは生HTMLを取得した後に、別枠のキュー(WRS:Web Rendering Service)に溜めて時間差でレンダリングする仕組みをとっています。そのため、JavaScriptに過度に依存したサイトは、Googleにとっても「クロールリソースを浪費し、インデックスや評価の更新にタイムラグが発生するリスク」を常に抱えています。
初期レスポンスの段階で主要なテキストを平文で出力する設計へ移行することは、下記の3つの効果を同時に達成します。
- Googlebotに対する即時インデックスの保証とクロールバジェットの節約
- Core Web Vitals等の表示パフォーマンス指標の改善
- コンテンツ(文章)の検索意図を一切薄めずに、AI検索への情報到達率だけを100%に引き上げる
「AIのためにコンテンツを書き換えてGoogle順位を落とす」のではなく、「Googleの評価基盤を強化しながら、AI検索の物理遮断を解除する」。これこそが、本稿が提示するフロントエンド要件の本質です。
3. 商用・自費診療サイトで脱落する4大コンポーネント
実務の現場において、モダンフロントエンド(Next.jsやNuxt.js)やWordPressの動的プラグインによって「AI完全不可視化」に陥っている代表的な要素は以下の4点です。
① クリック展開式のアコーディオン(料金表・詳細スペック)
スマートフォンの縦長スクロールを回避するために多用される「クリックすると開く料金表」や「よくある質問」です。初期HTMLに全テキストを書き出しておきCSSで非表示にしている構造(display: none)であればAIも読み取れます。しかし、「クリックされた瞬間にコンポーネントを生成する(条件付きレンダリング)」設計になっている場合、生HTMLには枠組みしか存在せず、AIからは「料金が一切記載されていないWebサイト」として処理されます。
② 医療広告ガイドライン関連情報(副作用・リスク・承認情報)
自費診療クリニックなどの詳細ページで、タブ切り替えによって表示される「施術のリスク・副作用」「未承認医薬品に関する表記」などの免責情報です。これらがJavaScriptのタブ切り替えイベントで動的に差し込まれている場合、AIクローラーはそれらを認識できません。AIが自社サイトを参照して施術概要を回答する際、リスク説明や安全情報が欠落した状態で処理されるリスクを抱えることになります。
③ ユーザー条件判定による予約・相談導線(主要CTA)
今回のB社の検証ログで実際に起きていた事象です。「アプリを開く」「Web予約に進む」「LINEで相談する」といったコンバージョンボタンを、ユーザーの端末(iOS/Android/PC)やログイン状態をクライアントサイドのJavaScriptで判定して出し分けているケースです。生HTML上にボタンのテキストが存在しないため、AIに対して「このクリニックの予約方法を教えて」と尋ねても、AIは「このページには予約や相談の導線が見当たりません」と回答することになります。
④ 非同期通信で読み込まれる動的データ(症例実績・口コミ・予約空き状況)
外部APIやデータベースから非同期(Fetch / Ajax)で引っ張ってきている「最新の予約枠の空き状況」「施術ごとの症例解説」「患者の口コミ一覧」です。初期HTMLを返送した後に非同期通信を行っているため、AI検索のフェッチャーは通信完了を待たずに切断します。結果として、最も差別化につながる一次情報がAIの回答生成プロセスから綺麗に抜け落ちます。
4. 「AIによる比較検討」の土俵から受ける直接打撃
AI検索を利用するユーザーの検索行動は、「単一サイトの閲覧」から「複数サイトを横断した比較・要約の要求」へ移行しています。
ユーザーがAIに対して、「〇〇駅周辺で、〇〇の施術を受けられるクリニックの費用と特徴を比較して」と指示を投げた際、自社サイトがGoogleでどれほど上位に位置していても、生HTMLに料金表や特徴が出力されていなければ、AIは他社の静的HTML(最初から文字が書かれているサイト)の情報を優先して引用します。
最悪の場合、自社は「費用:記載なし(不明)」として要約テーブルに並べられます。文章をどう装飾するかというテクニック以前に、「相手のロボットが読める形式でデータを出力しているか」という物理仕様の不備によって、商用の検討候補から静かに除外されているのが、現在多くのサイトが直面している現場リスクの本質です。
第5章:非機能要件定義――エンジニア・制作会社と握るべきHTML初期出力仕様
Webサイトの改修やリニューアルを行う際、制作会社や社内エンジニアに対して「AI検索(LLM)にも配慮した作りにしてください」と口頭で要望を伝えても、実効性のある実装にはつながりません。開発現場において、画面の見た目や操作性(機能要件)とは別に、「どのようにデータを配信するか」という土台の設計(非機能要件)を明文化して固定する必要があります。
Googleの検索順位を落とさず、同時に独立系AI検索の巡回ロボットにも100%のテキストを確実に届けるための具体的な要件定義を整理します。
1. フロントエンド設計における基本原則
AI検索に対する「完全不可視化」を防ぐための根本原則は、極めてシンプルです。
「主要なテキスト情報および重要導線は、クライアントサイド(ブラウザ)のJavaScript実行に依存せず、サーバーが最初に返送する生HTML(初期レスポンス)の中に平文で完全に書き出しておくこと」
Next.jsやNuxt.jsなどのモダンなフレームワークを採用する場合、CSR(クライアントサイドレンダリング)ではなく、SSR(サーバーサイドレンダリング)またはSSG(静的サイト生成)を標準仕様として指定します。WordPressなどのCMSを使用している場合であっても、プラグインや動的スクリプトによって後から差し込まれるパーツについては、同様の配慮が必要です。
2. 発注時・仕様策定時に指定すべき3つの具体的基準
制作会社への発注シートや要件定義書には、以下の3点を具体的な仕様として盛り込みます。
① 商用重要データの「初期HTML必須出力」
以下の4要素については、ブラウザ側のスクリプトが動かなくても初期HTMLの時点で文字情報として存在していなければならない、と規定します。
- 料金・費用に関する全データ:基本料金、オプション料金、追加費用の注記など。
- 主要アクションへの導線(CTAボタンのテキスト):「予約する」「問い合わせる」「オンライン相談」などのリンクテキスト。ユーザーの端末や条件による出し分けを行う場合でも、基本となる導線テキストは初期HTMLへ必ず記述する。
- 商品・施術の仕様およびリスク表記:特徴、成分、医療法やガイドラインに基づく副作用・注意事項のテキスト。
- 見出しタグ(h1〜h3)および主要な解説本文:ページの骨格となる文章全体。
② アコーディオン・タブUIの「CSS制御化」
スマートフォンの画面設計でよく使われる「開閉式アコーディオン」や「タブ切り替え」については、JavaScriptによる「条件付きレンダリング(クリックされるまでHTMLタグ自体を生成しない実装)」を禁止とします。
- 不適切な実装:クリックされた瞬間にReactの状態(State)を更新し、HTMLを動的に生成する。初期HTMLにテキストが存在しないため、AIからは空に見える。
- 適切な実装(最推奨・HTML5標準タグ):
<details>および<summary>タグを用いてネイティブに開閉を制御する。スクリプトが動かなくても初期HTML上に完全な平文テキストが存在し、AIの本文抽出パーサー(Readability等)からも不要要素として除外されにくいため、最も堅牢な実装となる。 - 適切な実装(次点・CSS表示制御):初期HTMLにすべての文章をあらかじめ出力しておき、CSSクラスの切り替え(display: none 等)で開閉を制御する。※ただし、一部の本文抽出エンジンは非表示属性を広告や定型文と誤認して無視する場合があるため、可能な限りHTML標準タグによる設計を優先する。
③ 外部API連携データのサーバー側プリフェッチ
症例一覧、口コミ、予約の空き状況などを外部データベースや別システムから取得する場合、ユーザーのブラウザ上で非同期通信(Fetch / Ajax)を走らせるのではなく、サーバー側で事前にデータを取得(プリフェッチ)し、HTMLの中に埋め込んだ状態で配信する仕様とします。
第6章:自社サイトの「AI完全不可視化」診断手順(現場の目視・判定フロー)
自社サイトや管理しているWebページが、現在AI検索に対して物理的にテキストを渡せているかどうかは、特殊な解析ツールを使わずとも、ブラウザと主要AIのチャット画面のみで即座に判定できます。現場で実施すべき2段階の診断フローを整理します。
手順1:生ソースコード検索(F12ではなく Ctrl + U)
Web担当者やディレクターが最も陥りやすい落とし穴が、「F12キー(または右クリックの『検証』)」でブラウザのデベロッパーツールを開いて確認してしまうことです。
- F12のElementsパネルで見えるもの:お使いのブラウザがHTML、CSS、JavaScriptをすべてダウンロードし、スクリプトを実行して画面を組み立てた後の「完成版DOMツリー」が表示されます。
- AIクローラーが見ているもの:JavaScriptが動く前、サーバーから通信で最初に送られてきた「生のプレーンHTMLテキスト」のみです。
Elementsパネルで文字が見えていても、AIのクローラーには1文字も届いていないケースが多発するのはこのためです。
【確認手順】
- 診断したいページをPCブラウザ(Google ChromeまたはMicrosoft Edge)で開きます。
- キーボードの Ctrl + U(Macは Option + Cmd + U)を押し、ページの生ソースコード画面(アドレスバーが view-source:https://... となる画面)を開きます。
- Ctrl + F を押し、ページ内で最も重要となる以下の文字列を検索します。
- 主要な施術や商品の「料金の数字」(例:33,000、税込)
- メインのアクションボタンの文言(例:WEB予約、カウンセリング予約、相談する)
- アコーディオンやタブの中に隠されている「解説文」や「副作用・注意事項」
- 検索ヒット数を確認します。
- 1件以上ヒットした場合:初期HTMLに平文で書き出されているため、AI検索にも届いている正常な状態です。
- 0 / 0(該当なし)となった場合:JavaScriptによって後から描画されているため、ChatGPTやClaudeからは完全に不可視化になっています。
手順2:主要AI窓を用いたブラックボックステスト
生ソースで文字が確認できたら、実際に主要なAIへURLを渡し、意図通りにデータが抽出されるかをテストします。
【投入プロンプト】
以下のURLの内容を確認してください。

1. このページに記載されている「料金(費用)」に関する項目と金額をすべて箇条書きで抜き出してください。
2. このページに設置されている主な「申し込み・相談・予約ボタン」の文言をそのまま抜き出してください。
3. このページで解説されている施術・商品の「リスク・注意事項」を箇条書きで教えてください。

URL: [診断対象のURL]
【合否判定の基準】
ChatGPT(Search機能オン)および Claude に投入します。
- 合格:実際の画面に表示されている通りの料金、ボタン文言、リスク文章が正確に箇条書きで出力された場合。
- 不合格(脱落):「料金に関する記載は見当たりませんでした」「予約ボタンは設置されていません」といった回答が返ってきた場合。初期HTMLへの出力漏れが発生しています。
- 不合格(ハルシネーション):画面上に存在しない架空のコース名や一般的な料金相場を作文して回答してきた場合。AIが生HTMLから本文を取得できず、ドメイン名や事前知識からそれらしい回答を捏造して取り繕っています。
判定後のトリアージ基準
診断結果に基づき、以下の基準で開発・改修タスクへ振り分けます。
- 生ソースで0件 + AIが「記載なし」またはハルシネーション:完全な脱落状態です。第5章で定義した「初期HTMLへの出力保証」を非機能要件としてチケット化し、エンジニアまたは制作会社へ改修を指示します。
- 生ソースでヒット + AIが正確に出力:通信レイヤーの遮断は起きていません。この状態であれば、ページ内のテキスト情報や構造化データは正常にAIへ届いています。あとは成約検索意図を薄めないコンテンツ設計に集中します。
Googleの成約意図を守り、AI検索にテキストを確実に届けるために
業界内では「LLMO」「GEO」といった新しいバズワードが次々と作られ、「AIに好かれるプロンプト風の文章術」や「引用を獲得するための文脈設計」といった小手先のテクニックが語られています。
しかし、独立した「AI向け文章術」など存在しません。AI向けの汎用解説を注ぎ込めばGoogleの商用順位が沈没し、本作で実証した通り、どれほど文章を工夫しようとJavaScriptに依存していれば、AI検索の巡回ロボットからは物理的に1文字も見えていません。
語るべきは文章の書き方(セマンティクス)ではなく、Web標準に則った配信仕様(インフラ)です。Googleの検索順位を維持・向上させるための設計と、次世代のAI検索に自社の情報を届けるための設計は、相反するものではありません。
- Googleに対しては:過剰なAI向け加筆を行わず、成約に近いユーザーが求める商用情報(価格、仕様、一次情報)に特化した純度の高いページ構造を維持する。
- AI検索に対しては:特殊な構文を模索するのではなく、最も伝えたい商用データ(料金、導線、諸元)を、サーバーが最初に返す生HTMLの中に平文で完全に書き出しておく。
相手の巡回ロボットが読める物理形式でデータを誠実に出力するという、Web標準の基礎を徹底することこそが、検索エンジンの順位を守りながら、AI検索の比較検討の土俵に自社を確実に残すための確実なアプローチです。